Moteurs d'analyse
AllyProof fait travailler trois moteurs en parallèle pour maximiser la détection. Le moteur principal, axe-core, applique une politique de zéro faux positif. Ensemble, ils produisent des non-conformités déterministes pour les schémas d'échec couverts par leurs règles, ainsi qu'une voie distincte d'éléments indicatifs pour les critères WCAG qui ne peuvent être automatisés que partiellement et appellent une revue humaine. Rien de tout cela n'établit la conformité - voir Couverture WCAG pour savoir sur quels critères chaque couche peut, ou non, se prononcer.
La chaîne de moteurs
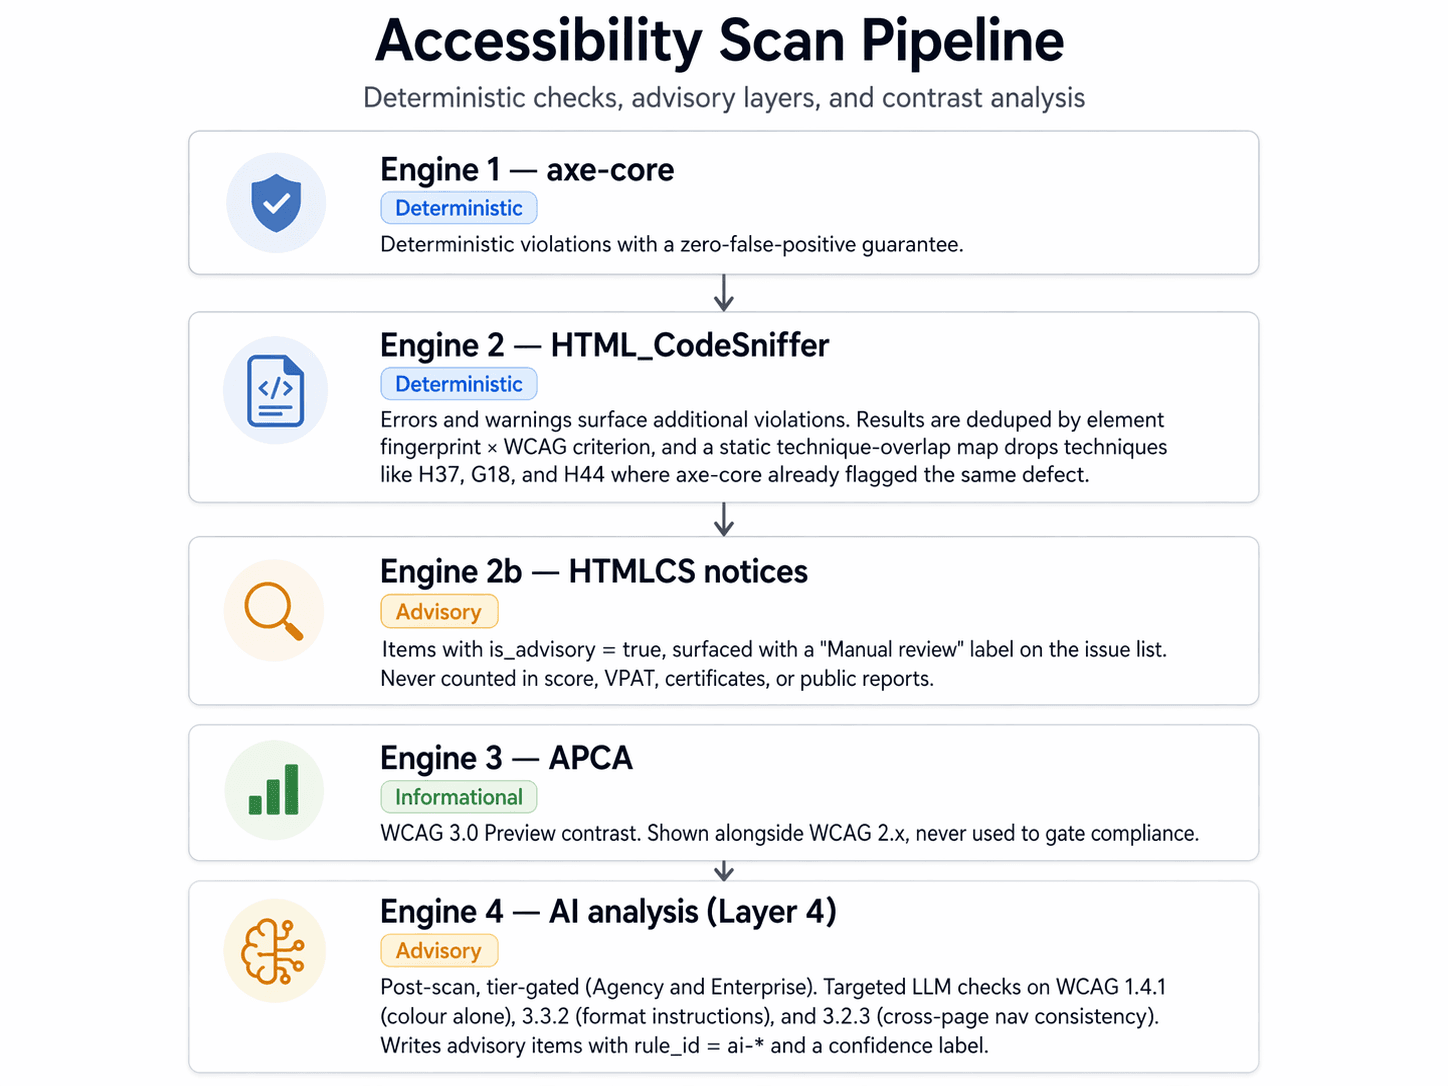
Chaîne d'analyse d'accessibilité : une architecture d'analyse en couches produisant des résultats déterministes, indicatifs, préliminaires et assistés par IA. Le moteur 1, axe-core, produit des non-conformités déterministes, les résultats nécessitant une revue manuelle étant tenus à part - c'est le moteur principal. Le moteur 2, HTML_CodeSniffer, produit des non-conformités supplémentaires à partir des erreurs et des avertissements. Les résultats sont dédoublonnés par empreinte d'élément combinée au critère de succès WCAG, et une table statique de recoupement des techniques écarte des techniques telles que H37, G18 et H44 lorsque axe-core a déjà signalé le même défaut. Le moteur 2b, les avis HTMLCS, correspond à des éléments indicatifs de revue manuelle pour lesquels is_advisory vaut true. Ils sont affichés avec la mention Revue manuelle et ne sont jamais comptabilisés dans le score, le VPAT, les certificats ni les rapports publics. Le moteur 3, APCA, est une vérification de contraste issue de la version préliminaire des WCAG 3.0 - purement informative, affichée à côté des WCAG 2.x mais jamais utilisée pour conditionner la conformité. Le moteur 4, l'analyse IA, s'exécute après l'analyse, est réservé aux offres Business et Enterprise et se déclenche de façon asynchrone sur la couche 4. Il cible les critères nécessitant un jugement humain : WCAG 1.4.1 couleur seule, 3.3.2 instructions de format et 3.2.3 cohérence de navigation entre pages. Il produit des éléments indicatifs dont le rule_id est préfixé par ai-, chacun assorti d'un niveau de confiance. Les résultats déterministes des moteurs 1 et 2 alimentent le score principal. Les couches indicative et préliminaire sont présentées séparément.
Lire la chaîne d'analyse sous forme de texte structuré
- Engine 1 - axe-coreDéterministe
Résultats d'accessibilité fondés sur des règles. Les résultats incertains nécessitent une revue manuelle.
- Engine 2 - HTML_CodeSnifferDéterministe
Les erreurs et avertissements font apparaître des non-conformités supplémentaires. Les résultats sont dédoublonnés par empreinte d'élément × critère de succès WCAG, et une table statique de recoupement des techniques écarte des techniques telles que
H37,G18etH44lorsque axe-core a déjà signalé le même défaut. - Engine 2b - Avis HTMLCSIndicatif
Éléments pour lesquels
is_advisory = true, affichés avec la mention « Revue manuelle » dans la liste des problèmes. Jamais comptabilisés dans le score, le VPAT, les certificats ni les rapports publics. - Engine 3 - APCAInformatif
Contraste selon la version préliminaire des WCAG 3.0. Affiché à côté des WCAG 2.x, jamais utilisé pour conditionner la conformité.
- Engine 4 - Analyse IA (couche 4)Indicatif
Après l'analyse, réservée aux offres Business et Enterprise. Vérifications ciblées par modèle de langage sur les critères WCAG 1.4.1 (couleur seule), 3.3.2 (instructions de format) et 3.2.3 (cohérence de navigation entre pages). Produit des éléments indicatifs avec
rule_id = ai-*et un niveau de confiance.
Pourquoi quatre voies, et non une liste unique
- Les résultats fondés sur des règles (axe et les résultats HTMLCS retenus) alimentent les scores et les rapports. Examinez les éléments consignés et la règle applicable : une anomalie logicielle, l'état de la page ou un contexte limité peuvent affecter tout résultat automatisé. Ces résultats ne certifient pas la conformité.
- Les éléments indicatifs (avis de HTMLCS) sont des invitations à une revue manuelle, pour les critères WCAG qu'aucun des deux moteurs ne peut entièrement automatiser :
1.4.1(information portée par la seule couleur),3.3.2(instructions de formulaire),2.1.1et2.4.7(comportement du focus dans les fenêtres modales et les carrousels),1.2.x(alternatives aux médias). Ils étaient auparavant écartés ; les conserver comble l'essentiel de l'écart de revue manuelle, sans coût d'exécution supplémentaire. - APCA est un aperçu informatif de l'algorithme de contraste des WCAG 3.0 : il est présenté à côté des résultats WCAG 2.x, et n'est jamais utilisé pour conditionner une conformité.
- L'analyse par IA (niveau 4) exécute trois vérifications ciblées par grand modèle de langage, sur des critères où le jugement compte davantage que la correspondance de règles. Réservée aux offres Business et Enterprise. Ses résultats sont indicatifs, assortis d'un niveau de confiance, et n'affectent jamais les scores ni les rapports à portée juridique.
Moteur 1 : axe-core (principal)
| Propriété | Valeur |
|---|---|
| Origine | Deque Systems (code ouvert) |
| Règles | 91 actives et 5 expérimentales |
| Normes | WCAG 2.0 / 2.1 / 2.2 A et AA, bonnes pratiques |
| Faux positifs | Aucun (politique stricte) |
| Couverture | Détection d'échecs pour 91 règles ; voir Couverture WCAG pour le détail critère par critère |
axe-core est le moteur de règles principal. La politique de Deque vise à éviter les faux positifs, tout en reconnaissant explicitement l'existence d'anomalies logicielles. Les résultats incomplets exigent une revue manuelle ; cette politique n'est pas une garantie pour la chaîne combinée d'AllyProof.
Règles expérimentales activées
css-orientation-lock- WCAG 1.3.4 Orientationlabel-content-name-mismatch- WCAG 2.5.3 Étiquette dans le nomp-as-heading- WCAG 1.3.1 Information et relationstable-fake-caption- WCAG 1.3.1 Information et relationstd-has-header- WCAG 1.3.1 Information et relations
Moteur 2 : HTML_CodeSniffer (secondaire)
| Propriété | Valeur |
|---|---|
| Origine | Squiz Labs (code ouvert) |
| Règles | Environ 200 |
| Normes | WCAG 2.1 A, AA, AAA |
| Intégration | Injection de script dans le navigateur |
| Faux positifs | Faibles (erreurs), moyens (avertissements) |
HTML_CodeSniffer emploie des algorithmes de détection différents de ceux d'axe-core, et relève ainsi des problèmes que la politique stricte de zéro faux positif d'axe conduit à écarter. Les identifiants de règles sont préfixés par htmlcs-, pour en identifier la source.
Comment fonctionne le dédoublonnage
Le dédoublonnage s'opère en deux couches, afin de ne jamais compter deux fois, ni écarter silencieusement un résultat légitime lorsque les deux moteurs divergent sur le détail tout en s'accordant sur l'élément.
Couche 1 - empreinte par couple élément-critère. Le outerHTML de chaque élément est normalisé (minuscules, espaces compactés, commentaires retirés, texte tronqué) en une empreinte stable. La clé de dédoublonnage est {empreinte}|{critère_wcag}. Un résultat HTMLCS n'est écarté que si axe a signalé le même élément en violation du même critère de succès. Si axe signale button-name sur un bouton et HTMLCS un défaut de contraste sur ce même bouton, les deux sont conservés : ce sont des problèmes distincts.
Couche 2 - table statique des recouvrements de techniques. Un ensemble codé en dur de codes de techniques HTMLCS (H37, G18, H44, F77, etc.) recense les cas où axe dispose d'une règle dédiée couvrant tout le périmètre. Ces résultats HTMLCS sont écartés indépendamment de l'empreinte - un filet de sécurité contre les différences de mise en forme. Volontairement prudente : lorsque HTMLCS détecte des cas limites qu'axe ne voit pas, le code reste hors de la table des recouvrements.
Types de messages et voies correspondantes
| Type HTMLCS | Voie | Marqueur | Comptabilisé ? |
|---|---|---|---|
| Erreur (1) | Non-conformité déterministe | impact=serious | Oui |
| Avertissement (2) | Non-conformité déterministe | impact=moderate | Oui |
| Avis (3) | Indicatif / revue manuelle | is_advisory=true | Non - présenté en ligne avec une pastille Manual review |
Les éléments indicatifs (avis de HTMLCS)
Les avis étaient auparavant écartés comme « trop verbeux ». Cela revenait à jeter précisément le signal nécessaire pour les critères qu'aucun des deux moteurs ne peut automatiser entièrement. Les avis sont désormais conservés comme éléments indicatifs, avec is_advisory=true :
| Propriété | Comportement des éléments indicatifs |
|---|---|
| Comptés dans le total des non-conformités | Non |
| Influent sur le score d'accessibilité | Non |
| Apparaissent dans les documents VPAT, récapitulatifs et rapports publics | Non |
| Alimentent les suggestions de correction par IA | Non |
| Présentés dans l'interface | Oui - en ligne dans la liste des problèmes, avec une pastille Manual review à la place de la pastille de gravité. La fiche s'ouvre sur un encadré orange expliquant ce qu'implique une revue manuelle. |
| Conservés d'une analyse à l'autre | Oui, avec un suivi de résolution séparé par voie |
| Comptés séparément | Oui - champ advisory_count sur les tâches d'analyse et les analyses de page |
Les avis dont la technique figure dans la table de recouvrement avec axe sont écartés : il n'y a aucun intérêt à demander « veuillez vérifier manuellement les alternatives textuelles » quand axe a déjà contrôlé chaque image. Tout le reste est conservé.
Moteur 3 : contraste APCA (aperçu)
| Propriété | Valeur |
|---|---|
| Origine | Myndex / brouillon WCAG 3.0 du W3C |
| Type | Calculateur de contraste perceptuel |
| Norme | WCAG 3.0 (brouillon) |
| Faux positifs | Aucun (calcul mathématique) |
Les WCAG 3.0 remplacent la formule de rapport de contraste des WCAG 2.x par l'APCA (Advanced Perceptual Contrast Algorithm). L'APCA tient compte de la taille et de la graisse de la police ainsi que de l'uniformité perceptuelle, et produit des prédictions de lisibilité plus justes.
Seuils Lc de l'APCA
| Valeur Lc | Usage |
|---|---|
| 90 et plus | Recommandé pour le texte courant |
| 75 | Minimum pour le texte courant (16 px en graisse normale) |
| 60 | Minimum pour le texte de grande taille ou en gras |
| 45 | Minimum pour les éléments d'interface non textuels |
| 30 | Minimum absolu pour tout texte |
Moteur 4 : analyse par IA (niveau 4 - Business et Enterprise)
| Propriété | Valeur |
|---|---|
| Exécution | De façon asynchrone, après l'achèvement de l'analyse déterministe |
| Conditionné par l'offre | Business et Enterprise uniquement |
| Modèle | Choisi par niveau d'offre par le superadministrateur (Anthropic / Google / OpenAI) |
| Plafond de coût | Environ 40 000 jetons par analyse, strictement plafonné |
| Sortie | Éléments indicatifs (is_advisory=true, identifiants de règles préfixés par ai-) |
| Compté dans les scores, les VPAT, les récapitulatifs | Non |
Après les niveaux 1 à 3, environ 30 % des critères WCAG de niveau AA restent hors de portée de l'analyse statique. La plupart exigent un jugement : « le sens de ce point rouge est-il transmis ailleurs ? », « cette étiquette indique-t-elle de saisir la date au format JJ/MM ? », « la navigation est-elle la même sur toutes les pages ? ». Un grand modèle de langage peut raisonner sur le DOM et son contexte d'une façon dont aucun moteur de règles n'est capable.
Le niveau 4 est volontairement étroit. Il exécute trois vérifications ciblées, là où l'IA présente le meilleur rapport signal-bruit, et non l'ensemble des critères WCAG possibles :
| Vérification | Critère | Ce que l'IA apprécie |
|---|---|---|
| Indicateur reposant sur la seule couleur | 1.4.1 Utilisation de la couleur | La couleur est-elle le seul indice, ou un texte, une icône ou une forme transmettent-ils aussi le sens ? |
| Instructions de format absentes | 3.3.2 Étiquettes ou instructions | Un champ exigeant un format (date, téléphone, code) communique-t-il le format attendu ? |
| Cohérence de la navigation | 3.2.3 Navigation cohérente | La navigation principale est-elle identique d'une page à l'autre ? (Seule l'IA peut comparer entre pages.) |
Fonctionnement
- Capture d'extraits pendant le passage du navigateur sur chaque page : jusqu'à 3 blocs de navigation, 20 champs de formulaire (avec leurs étiquettes, 300 caractères de contexte environnant et les indicateurs
patternetdescribedby), et 15 éléments porteurs d'une couleur d'état (filtrés par teinte calculée). Chaque région est plafonnée en taille et stockée danspage_scans.ai_snippets. - Contrôle de l'offre et choix du modèle. L'orchestrateur confronte l'offre de l'organisation à
aiScanAnalysiset lit le modèle configuré par le superadministrateur pour la charge d'analyse. - Échantillonnage des pages. Jusqu'à 3 pages par analyse - la page d'accueil est toujours incluse lorsqu'elle existe, accompagnée des pages offrant la masse d'extraits la plus intéressante. Le choix est déterministe, afin que les réexécutions tirent parti du cache.
- Appels groupés au modèle. Chaque vérification envoie des charges utiles JSON compactes, avec une consigne système prudente. Les résultats sont analysés de façon défensive : une sortie mal formée est écartée plutôt que de faire échouer toute la vérification.
- Enregistrement comme éléments indicatifs. Les résultats valides sont enregistrés dans
violationsavecis_advisory=true, unrule_idpréfixé parai-et un niveau de confiance. Ils apparaissent en ligne dans la liste des problèmes, avec la même pastille Manual review que les avis HTMLCS ; la fiche s'ouvre sur un encadré orange expliquant qu'il s'agit de résultats issus de l'IA.
Une politique de sortie prudente
- Couleur seule : le résultat doit invoquer l'absence d'un indice redondant précis ; en cas de doute, pencher vers « incertain ».
- Instructions de format : les champs libres retombent par défaut sur « no_format_required » ; seules les omissions avérées sont signalées.
- Cohérence de la navigation : les résultats peu sûrs sont purement et simplement écartés, les comparaisons entre pages présentant un risque élevé de faux positifs.
Choix du modèle
Le superadministrateur choisit le modèle par niveau d'offre dans le panneau AI Scan Analysis, sur le modèle du panneau AI Fix Suggestions. Configuration habituelle : un modèle de classe Haiku, moins coûteux, pour l'analyse des scans, qui s'exécute souvent, et un modèle plus puissant pour les suggestions de correction, qui s'exécutent moins souvent et demandent une analyse plus poussée. Fournisseurs disponibles : Anthropic (Claude), Google (Gemini), OpenAI (GPT).
Comparaison des couvertures
| Moteur ou couche | Règles | Offre | Contribution à la couverture |
|---|---|---|---|
| axe-core | 91 | Toutes | Détection déterministe des échecs (socle) |
| HTML_CodeSniffer (erreurs et avertissements) | Environ 200 | Toutes | +10 à 15 % de déterministe |
| HTML_CodeSniffer (avis → indicatifs) | Même jeu de 200 règles | Toutes | Comble environ 60 % de l'écart de revue manuelle |
| APCA | 1 (contraste) | Toutes | Aperçu des WCAG 3.0 |
| Analyse de scan par IA (niveau 4) | 3 vérifications ciblées | Business et Enterprise | Couvre les critères 1.4.1, 3.3.2 et 3.2.3 - ceux, à plus fort impact, que l'IA peut apprécier de façon fiable |
| Combinaison | Environ 290 + 3 vérifications IA | Selon l'offre | Détection déterministe des échecs, plus les éléments de revue manuelle signalés par l'IA et par HTMLCS pour ce que les règles ne peuvent pas trancher |
Le mur de sécurité autour de l'IA
La couche d'IA consomme du HTML extrait de sites tiers. Ce HTML n'est pas de confiance : un site malveillant pourrait y dissimuler un texte demandant au modèle d'exfiltrer des données, de fausser une classification, ou de produire une réponse contenant une injection de script. Le modèle lui-même n'a jamais d'accès direct à nos variables d'environnement ni à notre base de données ; la véritable surface d'attaque tient à (1) une réponse empoisonnée qui induirait les utilisateurs en erreur, (2) une injection de script persistante dans la sortie affichée, (3) une reconnaissance visant les outils ou les consignes, (4) un épuisement de ressources par une sortie gonflée, et (5) des URL hostiles dans le contenu produit par l'IA.
Isolation physique - le service ai-worker
Tout appel au modèle en production quitte l'application principale par HTTP, vers un service frère isolé situé dans services/ai-worker/. Ce service détient uniquement les clés des fournisseurs de modèles et un secret partagé HMAC. Il n'a ni client Supabase, ni clés Paddle, ni clés Resend, ni identifiants R2, ni écriture sur le système de fichiers (le conteneur s'exécute avec --read-only et --cap-drop=ALL), ni accès aux autres services. Il est rattaché au réseau Docker interne et n'est jamais exposé à l'internet. Les requêtes sont signées en HMAC-SHA256, avec une fenêtre anti-rejeu de 60 secondes et un corps plafonné à 1 Mo.
L'application principale appelle ce service par un point de passage unique (src/lib/ai/worker-client.ts). Les imports des kits de développement des fournisseurs sont dynamiques et encadrés par une solution de repli réservée au développement, bloquée en production. Une compromission du chemin d'accès au modèle - par injection de consigne, par la chaîne d'approvisionnement ou autrement - consomme donc des jetons, mais n'expose ni données d'utilisateurs, ni secrets d'organisation, ni identifiants de facturation.
Mur au niveau des consignes (défense en profondeur, dans les deux processus)
| Couche | Où | Rôle |
|---|---|---|
| Assainissement en entrée | Application principale | Retire <script>, <style>, <iframe>, les gestionnaires d'événements, les URI javascript:, vbscript: et data:text/html, les caractères de largeur nulle et bidirectionnels, les commentaires HTML, les attributs data-* et les marqueurs connus d'injection de consigne, avant qu'un extrait de DOM n'atteigne une consigne. Les éléments masqués visuellement sont vidés. |
| Encadrement de la consigne | Application principale | Tout contenu non fiable est placé entre les marqueurs UNTRUSTED_START et UNTRUSTED_END, avec un paragraphe de garde explicite et un rappel après le bloc. Les consignes système commencent par un préambule de sécurité commun, qui sépare les niveaux de confiance et interdit au modèle de révéler sa consigne système, ses outils ou son environnement. |
| Nettoyage côté service | ai-worker | Dernière occasion avant qu'une réponse ne franchisse la frontière. Retire du texte les scripts, styles, cadres, gestionnaires d'événements et URI dangereuses (les blocs de code encadrés sont préservés), supprime les caractères invisibles, et plafonne la réponse à 16 Ko. |
| Validation en sortie | Application principale | Chaque réponse est analysée au regard d'un schéma Zod strict. Le texte libre est nettoyé (balises HTML retirées, caractères invisibles supprimés, longueur plafonnée). Les URL doivent être en http ou https. Tout ce qui échoue à la validation est écarté silencieusement. |
| Échappement à l'affichage | Application principale | La sortie de l'IA est rendue par des nœuds de texte React et des coloriseurs de code dédiés - jamais par dangerouslySetInnerHTML. Même si un nettoyage avait laissé passer quelque chose, le navigateur reçoit du texte échappé. |
Aucune couche ne constitue à elle seule une frontière de sécurité. La valeur vient de la combinaison d'un périmètre d'isolation physique et de plusieurs garde-fous au niveau des consignes. Une réponse empoisonnée qui survivrait au nettoyage du service devrait encore passer la validation Zod de l'application principale - et quand bien même elle y parviendrait, elle n'atteindrait qu'un processus dépourvu des clés qu'un attaquant convoiterait. Le paramètre maxTokens est plafonné par appel, et le niveau 4 applique un budget de 40 000 jetons par analyse, qui s'interrompt dès qu'il est épuisé.
Ce qui reste manuel, même avec le niveau 4
Même avec les éléments indicatifs et l'analyse par IA, ces critères restent hors de portée de tout analyseur statique ou asynchrone : ils exigent des tests humains ou des sondes à l'exécution.
- 2.3.1 Clignotements photosensibles : exige une analyse de la fréquence d'images (PEAT).
- 3.3.1 / 3.3.3 Moment de l'annonce des erreurs : uniquement à l'exécution, avec une technologie d'assistance.
- 1.2.3 / 1.2.5 Qualité des sous-titres et de l'audio-description : leur présence est vérifiable, leur exactitude non.
- 2.1.1 / 2.4.3 Confinement et restitution du focus dans une fenêtre modale : comportement à l'exécution, nécessitant des sondes d'interaction Playwright (travail à venir, scriptable sans modèle de langage).